استخراج هوشمند محتوای فارسی از وب
از صفحات وب خام تا دادههای باکیفیت برای هوش مصنوعی
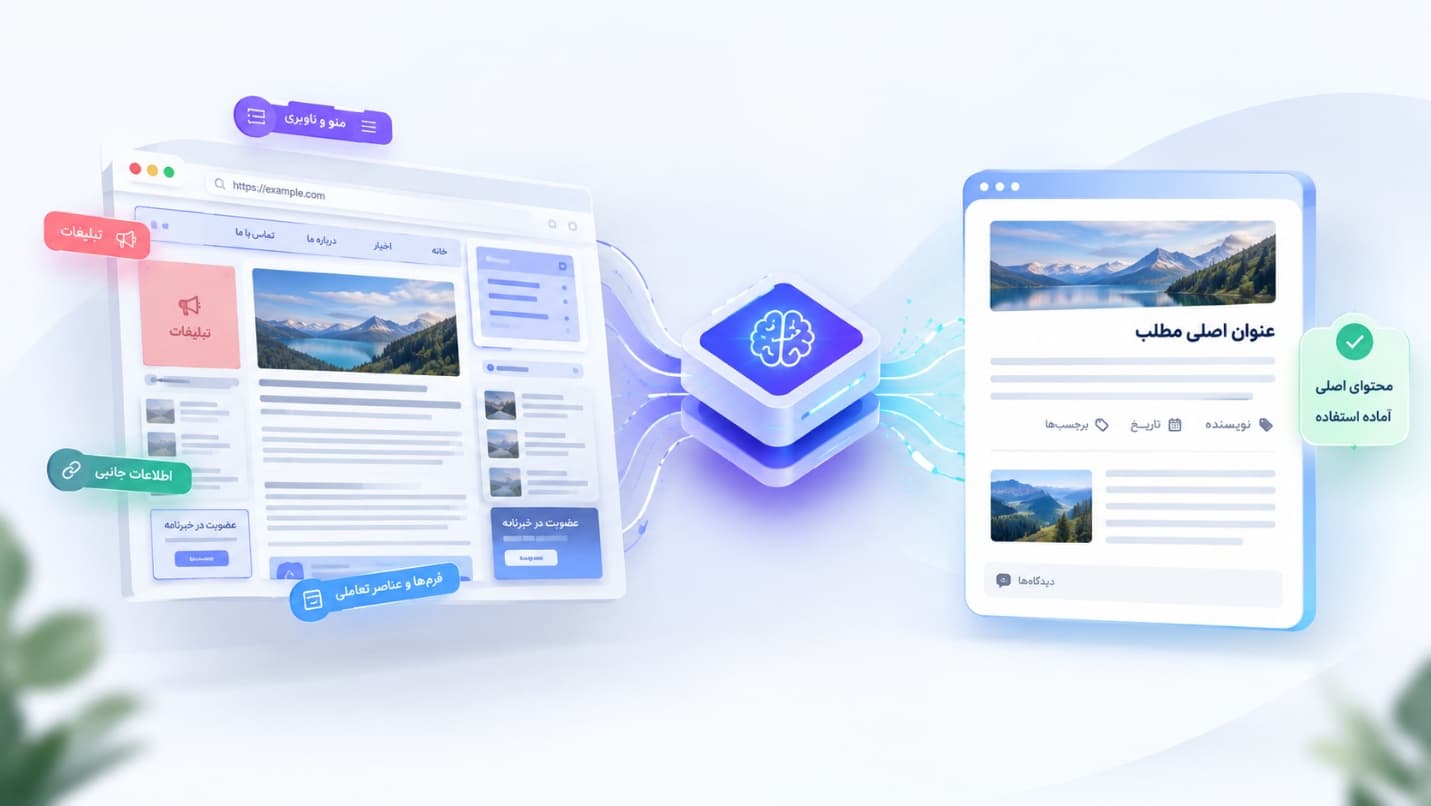
بخش قابل توجهی از محتوای صفحات وب شامل اطلاعاتی است که برای تحلیل، جستوجو یا آموزش مدلهای هوش مصنوعی کاربردی نیست. فناوری استخراج محتوای وب (Web Content Extraction) با شناسایی محتوای اصلی و حذف بخشهای غیرضروری، صفحات وب را به دادهای قابل استفاده تبدیل میکند.
ما راهکاری تخصصی برای استخراج محتوای فارسی، آمادهسازی دیتاست و توسعه محصولات مبتنی بر هوش مصنوعی ارائه میدهیم.
از صفحات وب خام تا داده قابل استفاده
صفحات وب فقط شامل محتوای اصلی نیستند؛ منوها، تبلیغات، لینکهای ناوبری و سایر عناصر جانبی نیز در کنار اطلاعات ارزشمند قرار گرفتهاند. استخراج محتوای وب با شناسایی و جداسازی این بخشها، محتوای مرتبط صفحه را برای استفاده در هوش مصنوعی و پردازش زبان طبیعی آماده میکند.
مدلهای زبانی
آمادهسازی دادههای وب برای آموزش و ارزیابی مدلهای زبانی.
سامانههای RAG
استخراج محتوای قابل استفاده برای بازیابی و تولید پاسخ.
موتورهای جستوجو
تمرکز نتایج جستوجو بر محتوای اصلی صفحات.
پایگاههای دانش
تبدیل اطلاعات پراکنده وب به داده قابل استفاده در سیستمهای هوشمند.
پردازش زبان طبیعی فارسی
ایجاد داده مناسب برای پروژههای پردازش زبان طبیعی فارسی.
تحلیل محتوای وب
استخراج محتوای اصلی مقالات، اخبار و صفحات اطلاعاتی.
راهکار ارائه شده مبتنی بر شبکههای عصبی
ساختار صفحات وب یک الگوی ثابت و از پیش تعریفشده ندارد. حتی در یک موضوع مشابه، نحوه قرارگیری عنوان، متن، اطلاعات تکمیلی و سایر عناصر میتواند از یک وبسایت تا وبسایت دیگر تفاوت قابلتوجهی داشته باشد. در چنین شرایطی، اتکا به قواعد ثابت، معمولاً با افزایش تنوع صفحات، محدودیت بیشتری پیدا میکند.
راهکار ارائهشده با تکیه بر شبکههای عصبی و یادگیری از دادههای واقعی وب فارسی، بهجای تعریف دستی مجموعهای از قوانین برای هر نوع صفحه، الگوهای مؤثر در تشخیص محتوای مرتبط را از نمونههای آموزشی میآموزد. این ویژگی باعث میشود تصمیمگیری تنها به یک نشانه یا ساختار مشخص وابسته نباشد و مجموعهای از ویژگیهای صفحه و ارتباط میان آنها در فرایند تشخیص مورد توجه قرار گیرد.
یکی از پایههای اصلی این رویکرد، استفاده از دادههای متنوع و دارای ساختارهای مختلف در فرایند آموزش است. قرار گرفتن صفحات متعلق به منابع، وبسایتها و قالبهای متفاوت در دادههای آموزشی، مدل را با طیف گستردهتری از الگوهای واقعی وب فارسی مواجه میکند. در نتیجه، یادگیری به یک قالب یا ساختار مشخص محدود نمیشود و زمینه برای عملکرد پایدارتر در مواجهه با صفحات جدید فراهم میشود.
از سوی دیگر، شبکههای عصبی امکان یادگیری روابط پیچیده میان ویژگیهای مختلف را فراهم میکنند؛ روابطی که تعریف آنها با مجموعهای از قواعد ساده و دستی دشوار است. به این ترتیب، سیستم میتواند از تجربه حاصل از نمونههای آموزشی برای ارزیابی صفحات جدید استفاده کند و با تغییرات موجود در ساختار و نحوه ارائه محتوا سازگارتر باشد.
استخراج محتوا از صفحات جدید
در این رویکرد، کیفیت صرفاً با عملکرد مدل روی دادههایی که در فرایند آموزش مشاهده کرده است سنجیده نمیشود؛ بلکه ارزیابی روی نمونههای جداگانه انجام میشود تا مشخص شود الگوهای آموختهشده تا چه اندازه در مواجهه با صفحات جدید نیز قابل استفاده هستند.
فرایند استخراج محتوا
فرایند استخراج در چند مرحله انجام میشود:
- ۱
دریافت و تحلیل صفحه
ساختار HTML و محتوای صفحه دریافت شده و برای تحلیل آماده میشود.
- ۲
بررسی ساختار و محتوا
ویژگیهای مرتبط با هر بخش از صفحه و جایگاه آن در ساختار کلی مورد بررسی قرار میگیرد.
- ۳
تشخیص محتوای مرتبط
مدل با استفاده از الگوهای آموختهشده، بخشهایی را که احتمال تعلق آنها به محتوای اصلی بیشتر است شناسایی میکند.
- ۴
تولید محتوای استخراجشده
بخشهای شناساییشده با حفظ ترتیب قرارگیری در صفحه، در قالب یک خروجی منسجم ارائه میشوند.
ترکیب یادگیری دادهمحور، تنوع نمونههای آموزشی و ارزیابی مستقل، پایهای برای توسعه راهکاری فراهم کرده است که بهجای وابستگی به ساختار یک منبع خاص، برای مواجهه با گستره متنوعتری از وب فارسی طراحی شده است. نتیجه، دادهای ساختیافتهتر و کمحجمتر است که میتواند بهعنوان یکی از مراحل اولیه در گردآوری و آمادهسازی دادههای فارسی برای پروژههای هوش مصنوعی مورد استفاده قرار گیرد.
عملکرد در استخراج محتوای فارسی
کیفیت خروجی الگوریتم با مقایسه متن استخراجشده و متن مرجع در سطح صفحه و با استفاده از معیارهای ROUGE-1، ROUGE-2 و ROUGE-L ارزیابی شده است. معیار ROUGE با مقایسه متن استخراجشده با متن مرجع، میزان شباهت آنها را میسنجد تا کیفیت استخراج مشخص شود.
نتایج نشان میدهند که متن استخراجشده تطابق بالایی با محتوای مرجع دارد و بخش عمده اطلاعات مورد انتظار صفحات با موفقیت شناسایی شده است.
| معیار | Recall | Precision | F1-Score |
|---|---|---|---|
| ROUGE-1 | 97.00 | 95.65 | 95.71 |
| ROUGE-2 | 96.66 | 95.29 | 95.37 |
| ROUGE-L | 95.34 | 93.45 | 94.43 |
دیتاست اختصاصی استخراج محتوای فارسی
در کنار توسعه الگوریتم، یک دیتاست اختصاصی برای استخراج محتوای مفید از صفحات وب فارسی ایجاد شده است. این مجموعه با استفاده از صفحات وب از منابع و دامنههای خبری تهیه شده و برای آموزش و ارزیابی راهکارهای استخراج محتوای فارسی طراحی شده است.
این دیتاست میتواند نقطه شروعی برای پژوهشگران و تیمهای فنی باشد که به داده فارسی برای توسعه و ارزیابی راهکارهای هوش مصنوعی نیاز دارند.
دیتاست اختصاصی محتوای مفید وب فارسی
دیتاست موردنیاز خود را با منابع و دامنههای موردنظر سفارش دهید.
زیرساخت داده برای نسل بعدی محصولات هوش مصنوعی
ما روی توسعه راهکارهایی تمرکز داریم که دادههای وب فارسی را به ورودی قابل استفاده برای سیستمهای هوشمند تبدیل میکنند.
اگر برای محصول خود به استخراج، پاکسازی یا آمادهسازی محتوای فارسی از وب نیاز دارید، با ما در ارتباط باشید.
داده بهتر، نقطه شروع هوش مصنوعی بهتر است.